
同一角色换新场景还要认得出来
把同一张脸和衣服当 Image 1,再写新动作。身份跟着走是设计目标,不是像素级保证——对照参考看结果。
都来自这个模型自己的示例库。和上面生成器跑的是同一套参考生视频,同一组参考,出了两版。
参考:Image 1 是近处男人的单人照;Image 2 是远处男人的单人照——两人从没一起拍过。提示词:"The near man says flatly: 'Did you hear about H3 Max?' A beat of silence, wind moving across the lot. The far man's mouth pulls into a slow half-smile and he answers, warm and certain: 'Dude, I love it.' The near man exhales and shakes his head once, almost smiling. Native audio, lip-synced English dialogue, distant traffic hum, wind. No music, no subtitles, no camera movement." 结果把两个人放进同一条生成镜头,各自的脸和衣服跟自己那张单人照走,对白也是同一次生成的原生对口型音轨。
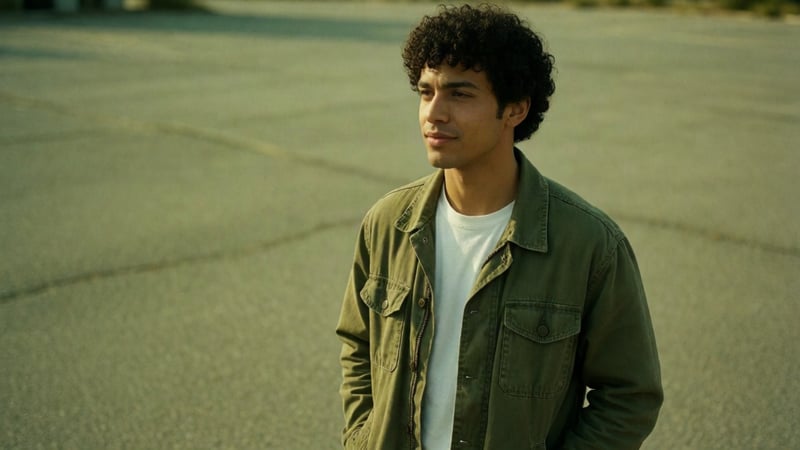
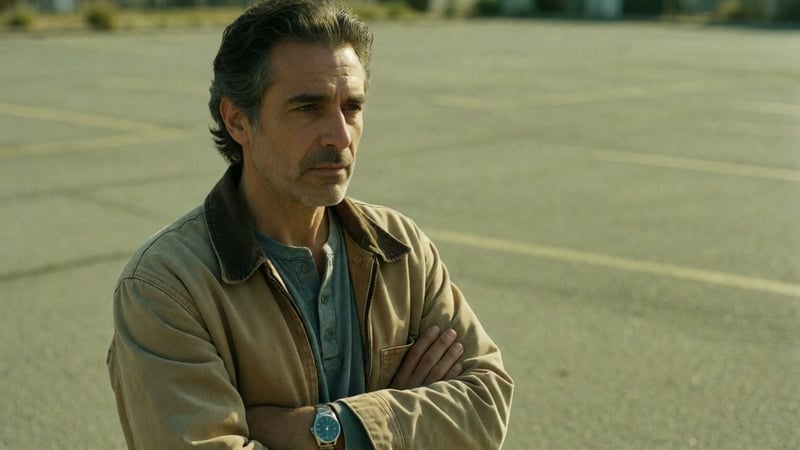
主体、角色或风格参考——在提示词里写成 Image 1、Image 2,依此类推。
运动或运镜参考,每段 2–15 秒,合计不超过 15 秒——写成 Video 1、Video 2。
声音或环境音参考,每段 2–15 秒——写成 Audio 1、Audio 2。三种都可以单独不上;混着搭配,总共最多 12 个文件。
画幅默认自适应,跟着参考走;也可以从六种固定画幅里选一个。
和这个模型的文生视频、图生视频同一套三档——480P 先看一眼,留下的那条上 768P 或 1080P。
付费套餐上,同一组参考和提示词可以一次出多条;第一条所有套餐都能出。
最多 9 张图、3 段视频(各 2–15 秒)、3 段音频(各 2–15 秒)——总共不超过 12 个文件,三种都可以单独不上。
按种类和顺序点名——Image 1、Video 1、Audio 1——再写新动作。模型认的是这个顺序,不是文件名。
480P、768P 或 1080P;5 到 15 秒;画幅默认自适应。看完结果,改一个参考或改一行,再跑一版。
要点是把已经有的东西带进新镜头,不是从空白提示词开始。
把同一张脸和衣服当 Image 1,再写新动作。身份跟着走是设计目标,不是像素级保证——对照参考看结果。
包装或产品参考把颜色、外形和标签稳住,场景其他部分随便换。
一段短参考视频可以把运镜——横摇、推轨、旋转——借给新的主体和场景。
一段参考音频把声音钉住,提示词给这场戏写新对白。
角色图、产品图、一小段运动视频写进同一句提示词——三种加起来最多 12 个文件。
成片那组参考留着,只改提示词里的对白,再出一版新语言。
图生视频把一张静图当成片子的开场第一帧。参考生视频把最多 12 个图、视频和音频当素材,新片子从里面抽主体、风格、运动或声音——它们不必是开场帧,也可以一次用多个。
不用。参考图、视频、音频各自都可以不上——可以只上图、只上一段视频,或随便混,只要总数不超过 12。
在提示词里按种类和顺序点名——Image 1、Image 2、Video 1、Audio 1——和你上传的顺序对上。模型认的是这个顺序,不是文件名。
每段 2 到 15 秒。视频合计不超过 15 秒,音频合计另算,也是 15 秒。
480P、768P 或 1080P,5 到 15 秒。画幅默认自适应,跟着参考走;也可以锁成六种比例之一。
和这个模型的文生视频、图生视频同一套每秒价格:480P 每秒 7 积分,768P 每秒 15,1080P 每秒 30——一条 5 秒 480P 是 35 积分。
一致性是目标,不是保证——对照参考看实际结果,尤其是要认脸或要对产品细节的时候。
上面的生成器里:选 MiniMax H3 Max,再点「参考图生视频」这个页签。本页「跑一组参考」的链接打开的就是它。
480P 每秒 7 积分,768P 每秒 15,1080P 每秒 30——和这个模型的文生视频、图生视频同一张表。一条 5 秒 480P 是 35 积分。
享受限时 7 折优惠!
最多 12 个图、视频和音频进去。出来一条新视频,参考里的主体、风格、运动或声音跟着走。